
Lý thuyết Tin học 12 Bài 3 (Cánh diều): Giới thiệu về khoa học dữ liệu (Tiếp theo)
Tóm tắt lý thuyết Tin học lớp 12 Bài 3: Giới thiệu về khoa học dữ liệu (Tiếp theo) hay, chi tiết sách Cánh diều sẽ giúp học sinh nắm vững kiến thức trọng tâm, ôn luyện để học tốt Tin học 12.
Lý thuyết Tin học 12 Bài 3: Giới thiệu về khoa học dữ liệu (Tiếp theo)
1. Các đặc trưng của dữ liệu lớn
Dữ liệu lớn (Big Data):
- Định nghĩa: Dữ liệu lớn là nguồn dữ liệu có khối lượng rất lớn, tính đa dạng và phức tạp, khó xử lý bằng công cụ truyền thống.
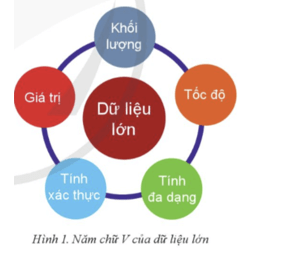
- Đặc trưng (5 chữ V):
+ Khối lượng (Volume): Dữ liệu có thể đạt nhiều petabyte hoặc exabyte. Ví dụ: Dữ liệu về khách hàng của một doanh nghiệp lớn.
+ Tốc độ (Velocity): Dữ liệu được tạo ra nhanh chóng và cần xử lý theo thời gian thực. Ví dụ: Dữ liệu từ thiết bị cảm biến và mạng xã hội.
+ Tính đa dạng (Variety): Dữ liệu đến từ nhiều nguồn và dưới nhiều dạng như văn bản, hình ảnh, âm thanh. Ví dụ: Dữ liệu từ Facebook.
+ Tính xác thực (Veracity): Đề cập đến độ tin cậy và chính xác của dữ liệu. Quan trọng để đảm bảo hiểu biết từ dữ liệu là chính xác.
+ Giá trị (Value): Dữ liệu lớn có tiềm năng tạo ra thông tin giá trị cho quyết định. Ví dụ: Dự án Bộ gen người HGP.
- Thách thức: Quản lý và khai thác dữ liệu lớn có nhiều thách thức về lưu trữ, xử lý, và đảm bảo chất lượng dữ liệu.
2. Phân tích dữ liệu, phát hiện tri thức
a) Phân tích dữ liệu:
Phân tích dữ liệu là quá trình kiểm tra, làm sạch, chuyển đổi và lập mô hình dữ liệu để tìm ra thông tin hữu ích cho kết luận hoặc dự đoán. Phân tích dữ liệu được chia thành hai loại:
- Phân tích mô tả: Tóm tắt dữ liệu quá khứ và trình bày trực quan để người sử dụng dễ dàng nắm bắt thông tin quan trọng. Thông tin được biểu diễn bằng sơ đồ, biểu đồ, đồ thị,... giúp nhận ra các mẫu hoặc xu hướng, cung cấp cái nhìn tổng thể về vấn đề.
- Phân tích dự đoán: Nhằm đưa ra dự đoán hoặc phân loại dữ liệu mới.
b) Khai phá dữ liệu, phát hiện tri thức:
Khai phá dữ liệu là một bước trong quy trình phát hiện tri thức, nhằm phát hiện các mẫu và xu hướng trong tập dữ liệu. Quy trình phát hiện tri thức bao gồm toàn bộ việc trích xuất tri thức từ dữ liệu. Khai phá dữ liệu thường sử dụng các phương pháp giao thoa giữa học máy và thống kê. Các kĩ thuật khai phá dữ liệu khác nhau, như phân loại và phân cụm, giúp trích xuất thông tin hữu ích từ các tập dữ liệu lớn.
3. Vai trò của máy tính và thuật toán ưu việt với Khoa học dữ liệu
a) Máy tính là công cụ quan trọng trong Khoa học dữ liệu:
Vai trò của máy tính và thuật toán ưu việt với Khoa học dữ liệu
- Tạo dữ liệu lớn: Mạng xã hội, thiết bị di động, cảm biến đã tạo ra lượng lớn dữ liệu hàng ngày.
- Công cụ thiết yếu: Máy tính và thiết bị số lưu trữ và xử lý dữ liệu hiệu quả, thúc đẩy sự phát triển của Khoa học dữ liệu.
- Phân tích dữ liệu: Trước đây, chuyên gia thực hiện phân tích dữ liệu; hiện nay, máy tính đóng vai trò quan trọng trong việc xử lý và phân tích dữ liệu.
- Giai đoạn dự án: Máy tính hỗ trợ trong các giai đoạn như thu thập, chuẩn bị và phân tích dữ liệu.
- Khả năng lưu trữ: Máy tính cung cấp khả năng lưu trữ và quản lý dữ liệu hiệu quả.
- Trí tuệ nhân tạo và Học máy: Phát triển các công cụ và thuật toán để mô hình hóa dữ liệu và tự động phát hiện tri thức.
- Nghề nghiệp: Nhà khoa học dữ liệu được xếp hạng cao trong các nghề công nghệ và dự đoán tăng trưởng việc làm cao trong tương lai.
b) Máy tính và thuật toán ưu việt giúp phân tích dữ liệu hiệu quả:
- Phần mềm phân tích dữ liệu: Máy tính chạy phần mềm để mô hình hóa và phát hiện tri thức trong dữ liệu, giúp chuyên gia phát hiện vấn đề và đề xuất giải pháp.
- Siêu máy tính: Có tốc độ hàng nghìn tỉ phép tính/giây và bộ nhớ lớn, giúp quản lý và phân tích dữ liệu lớn hiệu quả.
- Điện toán đám mây: Cho phép lưu trữ và truy cập dữ liệu lớn mọi lúc mọi nơi, tiết kiệm chi phí cơ sở hạ tầng và linh hoạt trong mở rộng hoặc thu hẹp tài nguyên. Ví dụ: Amazon Web Services, Microsoft Azure.
- Cơ sở dữ liệu NoSQL: Phù hợp với dữ liệu không cấu trúc, cho phép lưu trữ linh hoạt và dễ mở rộng. Ví dụ: Amazon DynamoDB, Google MongoDB, Apache Hadoop.
- Máy tính cụm: Tập hợp nhiều máy tính hoạt động như một máy tính duy nhất, có tính sẵn sàng cao, dễ quản lý và tiết kiệm chi phí.
- Thuật toán song song: Thực hiện nhiều phép tính đồng thời, giúp xử lý dữ liệu lớn nhanh chóng và hiệu quả.
Trắc nghiệm: Giới thiệu về khoa học dữ liệu (Tiếp theo)
PHẦN I. Câu trắc nghiệm nhiều phương án lựa chọn. Thí sinh trả lời từ câu 1 đến câu 10. Mỗi câu hỏi thí sinh chỉ lựa chọn một phương án.
Câu 1: Dữ liệu lớn (Big Data) có khối lượng thường được đo bằng đơn vị nào?
A. Megabyte
B. Gigabyte
C. Terabyte
D. Petabyte
Đáp án: D
Giải thích: Dữ liệu lớn thường có khối lượng rất lớn, thường đo bằng petabyte hoặc thậm chí exabyte, cao hơn nhiều so với megabyte, gigabyte và terabyte.
Câu 2: Trong 5 chữ V của dữ liệu lớn, "Velocity" đề cập đến điều gì?
A. Độ tin cậy của dữ liệu
B. Tốc độ tạo ra và xử lý dữ liệu
C. Tính đa dạng của dữ liệu
D. Giá trị của dữ liệu
Đáp án: B
Giải thích: "Velocity" trong bối cảnh dữ liệu lớn ám chỉ tốc độ nhanh chóng mà dữ liệu được tạo ra và cần phải được xử lý, đặc biệt là dữ liệu thời gian thực từ các nguồn như mạng xã hội và cảm biến.
Câu 3: Tính đa dạng (Variety) trong dữ liệu lớn đề cập đến điều gì?
A. Khối lượng của dữ liệu
B. Tốc độ xử lý dữ liệu
C. Nhiều loại dữ liệu khác nhau như văn bản, hình ảnh, âm thanh
D. Độ tin cậy của dữ liệu
Đáp án: C
Giải thích: Tính đa dạng trong dữ liệu lớn đề cập đến việc dữ liệu đến từ nhiều nguồn và có nhiều dạng khác nhau như văn bản, hình ảnh, âm thanh, video.
Câu 4: Khai phá dữ liệu chủ yếu sử dụng các kỹ thuật từ lĩnh vực nào?
A. Y học và sinh học
B. Vật lý và hóa học
C. Học máy và thống kê
D. Lịch sử và văn học
Đáp án: C
Giải thích: Khai phá dữ liệu là quá trình trích xuất thông tin hữu ích từ dữ liệu lớn, và nó thường sử dụng các kỹ thuật từ học máy và thống kê để tìm ra các mẫu và xu hướng.
Câu 5: Máy tính và thuật toán ưu việt có vai trò gì trong Khoa học dữ liệu?
A. Chỉ lưu trữ dữ liệu
B. Chỉ tạo ra dữ liệu
C. Xử lý và phân tích dữ liệu hiệu quả
D. Chỉ hiển thị dữ liệu
Đáp án: C
Giải thích: Máy tính và thuật toán ưu việt giúp xử lý và phân tích dữ liệu hiệu quả, từ việc lưu trữ đến phân tích, đặc biệt quan trọng trong bối cảnh dữ liệu lớn.
Câu 6: Phân tích mô tả trong phân tích dữ liệu nhằm mục đích gì?
A. Dự đoán xu hướng tương lai
B. Tìm ra thông tin mới
C. Tóm tắt dữ liệu quá khứ và trình bày trực quan
D. Tạo ra dữ liệu mới
Đáp án: C
Giải thích: Phân tích mô tả tập trung vào việc tóm tắt dữ liệu quá khứ và trình bày chúng một cách trực quan để giúp người dùng nhận diện các mẫu hoặc xu hướng trong dữ liệu.
Câu 7: Điện toán đám mây giúp trong việc gì đối với dữ liệu lớn?
A. Tăng tốc độ xử lý dữ liệu
B. Lưu trữ và truy cập dữ liệu từ xa
C. Tăng tính đa dạng của dữ liệu
D. Giảm tính xác thực của dữ liệu
Đáp án: B
Giải thích: Điện toán đám mây cung cấp khả năng lưu trữ và truy cập dữ liệu từ bất kỳ đâu, giúp tiết kiệm chi phí cơ sở hạ tầng và cung cấp tính linh hoạt trong việc mở rộng hoặc thu hẹp tài nguyên.
Câu 8: Cơ sở dữ liệu NoSQL phù hợp với loại dữ liệu nào?
A. Dữ liệu có cấu trúc
B. Dữ liệu phi cấu trúc
C. Dữ liệu số
D. Dữ liệu văn bản
Đáp án: B
Giải thích: Cơ sở dữ liệu NoSQL được thiết kế để xử lý dữ liệu phi cấu trúc, như dữ liệu từ mạng xã hội, video, và hình ảnh, cho phép lưu trữ linh hoạt và dễ mở rộng.
Câu 9: Máy tính cụm là gì?
A. Một máy tính đơn lẻ với hiệu năng cao
B. Tập hợp nhiều máy tính hoạt động như một máy tính duy nhất
C. Một loại siêu máy tính
D. Máy tính dùng cho việc lập trình
Đáp án: B
Giải thích: Máy tính cụm là một tập hợp các máy tính hoạt động cùng nhau như một hệ thống duy nhất, cung cấp khả năng xử lý dữ liệu lớn với hiệu suất cao.
Câu 10: Thuật toán song song giúp ích gì trong xử lý dữ liệu lớn?
A. Giảm khối lượng dữ liệu
B. Tăng tính đa dạng của dữ liệu
C. Thực hiện nhiều phép tính đồng thời
D. Cải thiện tính xác thực của dữ liệu
Đáp án: C
Giải thích: Thuật toán song song cho phép thực hiện nhiều phép tính cùng một lúc, giúp xử lý dữ liệu lớn nhanh chóng và hiệu quả hơn.
PHẦN II. Câu trắc nghiệm đúng sai. Thí sinh trả lời từ câu 1 đến câu 2. Trong mỗi ý a), b), c), d) ở mỗi câu, thí sinh chọn đúng hoặc sai
Câu 1: Đặc trưng của dữ liệu lớn (Big Data) bao gồm những yếu tố sau đây là đúng hay sai?
a) Khối lượng (Volume) của dữ liệu thường nhỏ, dễ dàng quản lý.
b) Tốc độ (Velocity) của dữ liệu tạo ra nhanh chóng và cần xử lý theo thời gian thực.
c) Tính đa dạng (Variety) của dữ liệu bao gồm các loại dữ liệu như văn bản, hình ảnh, và âm thanh.
d) Tính xác thực (Veracity) liên quan đến độ tin cậy và chính xác của dữ liệu.
a) Sai. Khối lượng của dữ liệu lớn (Big Data) thường rất lớn, có thể đạt đến nhiều petabyte hoặc exabyte, không phải nhỏ và dễ dàng quản lý.
b) Đúng. Tốc độ của dữ liệu (Velocity) là tốc độ mà dữ liệu được tạo ra và cần được xử lý, thường là theo thời gian thực.
c) Đúng. Tính đa dạng (Variety) bao gồm nhiều loại dữ liệu khác nhau như văn bản, hình ảnh, âm thanh, và nhiều loại khác.
d) Đúng. Tính xác thực (Veracity) liên quan đến độ tin cậy và chính xác của dữ liệu, đảm bảo thông tin lấy từ dữ liệu là đúng.
Câu 2: Phát biểu sau đây đúng hay sai về sự giúp ích của Máy tính và thuật toán trong Khoa học dữ liệu ?
a) Máy tính chỉ lưu trữ dữ liệu, không có vai trò trong phân tích dữ liệu.
b) Thuật toán song song giúp xử lý dữ liệu lớn nhanh chóng và hiệu quả.
c) Siêu máy tính có khả năng thực hiện hàng nghìn tỉ phép tính/giây.
d) Điện toán đám mây không liên quan đến Khoa học dữ liệu.
a) Sai. Máy tính không chỉ lưu trữ mà còn đóng vai trò quan trọng trong phân tích dữ liệu, bao gồm xử lý, mô hình hóa, và phát hiện tri thức từ dữ liệu.
b) Đúng. Thuật toán song song cho phép thực hiện nhiều phép tính cùng một lúc, giúp xử lý dữ liệu lớn nhanh chóng và hiệu quả.
c) Đúng. Siêu máy tính có khả năng thực hiện một lượng lớn phép tính với tốc độ rất cao, thường đo bằng hàng nghìn tỉ phép tính/giây, giúp trong việc phân tích dữ liệu lớn.
d) Sai. Điện toán đám mây là một phần quan trọng trong Khoa học dữ liệu, cung cấp khả năng lưu trữ và truy cập dữ liệu lớn linh hoạt và hiệu quả.
PHẦN III. Câu trả lời ngắn. Thí sinh trả lời từ câu 1 đến câu 3
Câu 1: Đặc trưng nào của dữ liệu lớn (Big Data) đề cập đến độ tin cậy và chính xác của dữ liệu?
Đáp án: Tính xác thực (Veracity)
Giải thích: Tính xác thực (Veracity) trong dữ liệu lớn đề cập đến độ tin cậy và chính xác của dữ liệu. Đây là yếu tố quan trọng để đảm bảo rằng thông tin lấy từ dữ liệu là chính xác và có thể sử dụng được cho các quyết định kinh doanh và phân tích.
Câu 2: Trong quá trình phân tích dữ liệu, phân tích mô tả và phân tích dự đoán khác nhau như thế nào?
Đáp án: Phân tích mô tả tập trung vào tóm tắt và trình bày dữ liệu quá khứ, trong khi phân tích dự đoán hướng tới việc đưa ra dự đoán hoặc phân loại dữ liệu mới.
Giải thích:
Phân tích mô tả là quá trình tóm tắt dữ liệu quá khứ và trình bày thông tin một cách trực quan, giúp người dùng dễ dàng nắm bắt các mẫu và xu hướng trong dữ liệu.
Phân tích dự đoán là quá trình sử dụng dữ liệu hiện tại và quá khứ để đưa ra dự đoán hoặc phân loại dữ liệu mới. Nó giúp đưa ra các dự đoán về xu hướng tương lai hoặc phân loại các đối tượng trong dữ liệu.
Câu 3: Điện toán đám mây có vai trò gì trong Khoa học dữ liệu?
Đáp án: Điện toán đám mây cung cấp khả năng lưu trữ và truy cập dữ liệu lớn mọi lúc mọi nơi, tiết kiệm chi phí cơ sở hạ tầng và linh hoạt trong mở rộng hoặc thu hẹp tài nguyên.
Giải thích: Điện toán đám mây cho phép các tổ chức lưu trữ lượng lớn dữ liệu và truy cập chúng từ bất kỳ đâu, giảm thiểu chi phí liên quan đến cơ sở hạ tầng vật lý. Nó cũng cung cấp tính linh hoạt cao, cho phép mở rộng hoặc giảm tài nguyên theo nhu cầu của dự án Khoa học dữ liệu. Ví dụ như Amazon Web Services và Microsoft Azure cung cấp các dịch vụ điện toán đám mây phổ biến cho các ứng dụng dữ liệu lớn.
Xem thêm các chương trình khác:
- Soạn văn 12 Cánh diều (hay nhất)
- Văn mẫu 12 - Cánh diều
- Tóm tắt tác phẩm Ngữ văn 12 – Cánh diều
- Tác giả tác phẩm Ngữ văn 12 - Cánh diều
- Bố cục tác phẩm Ngữ văn 12 – Cánh diều
- Nội dung chính tác phẩm Ngữ văn 12 – Cánh diều
- Giải Chuyên đề học tập Ngữ văn 12 – Cánh diều
- Giải sgk Toán 12 – Cánh diều
- Giải Chuyên đề học tập Toán 12 – Cánh diều
- Lý thuyết Toán 12 – Cánh diều
- Giải sbt Toán 12 – Cánh diều
- Giải sgk Tiếng Anh 12 - ilearn Smart World
- Trọn bộ Từ vựng Tiếng Anh lớp 12 ilearn Smart World đầy đủ nhất
- Trọn bộ Ngữ pháp Tiếng Anh lớp 12 ilearn Smart World đầy đủ nhất
- Giải sbt Tiếng Anh 12 – iLearn Smart World
- Giải sgk Vật lí 12 – Cánh diều
- Giải Chuyên đề học tập Vật lí 12 – Cánh diều
- Lý thuyết Vật lí 12 – Cánh diều
- Giải sbt Vật lí 12 – Cánh diều
- Giải sgk Hóa học 12 – Cánh diều
- Giải Chuyên đề học tập Hóa 12 – Cánh diều
- Lý thuyết Hóa 12 – Cánh diều
- Giải sbt Hóa 12 – Cánh diều
- Giải sgk Sinh học 12 – Cánh diều
- Giải Chuyên đề học tập Sinh học 12 – Cánh diều
- Lý thuyết Sinh học 12 – Cánh diều
- Giải sbt Sinh học 12 – Cánh diều
- Giải sgk Lịch sử 12 – Cánh diều
- Giải Chuyên đề học tập Lịch sử 12 – Cánh diều
- Giải sbt Lịch sử 12 – Cánh diều
- Lý thuyết Lịch sử 12 – Cánh diều
- Giải sgk Địa lí 12 – Cánh diều
- Giải Chuyên đề học tập Địa lí 12 – Cánh diều
- Giải sbt Địa lí 12 – Cánh diều
- Lý thuyết Địa lí 12 – Cánh diều
- Giải sgk Công nghệ 12 – Cánh diều
- Lý thuyết Công nghệ 12 – Cánh diều
- Giải sgk Kinh tế pháp luật 12 – Cánh diều
- Giải Chuyên đề học tập Kinh tế pháp luật 12 – Cánh diều
- Giải sbt Kinh tế pháp luật 12 – Cánh diều
- Giải sgk Giáo dục quốc phòng 12 – Cánh diều
- Giải sgk Hoạt động trải nghiệm 12 – Cánh diều